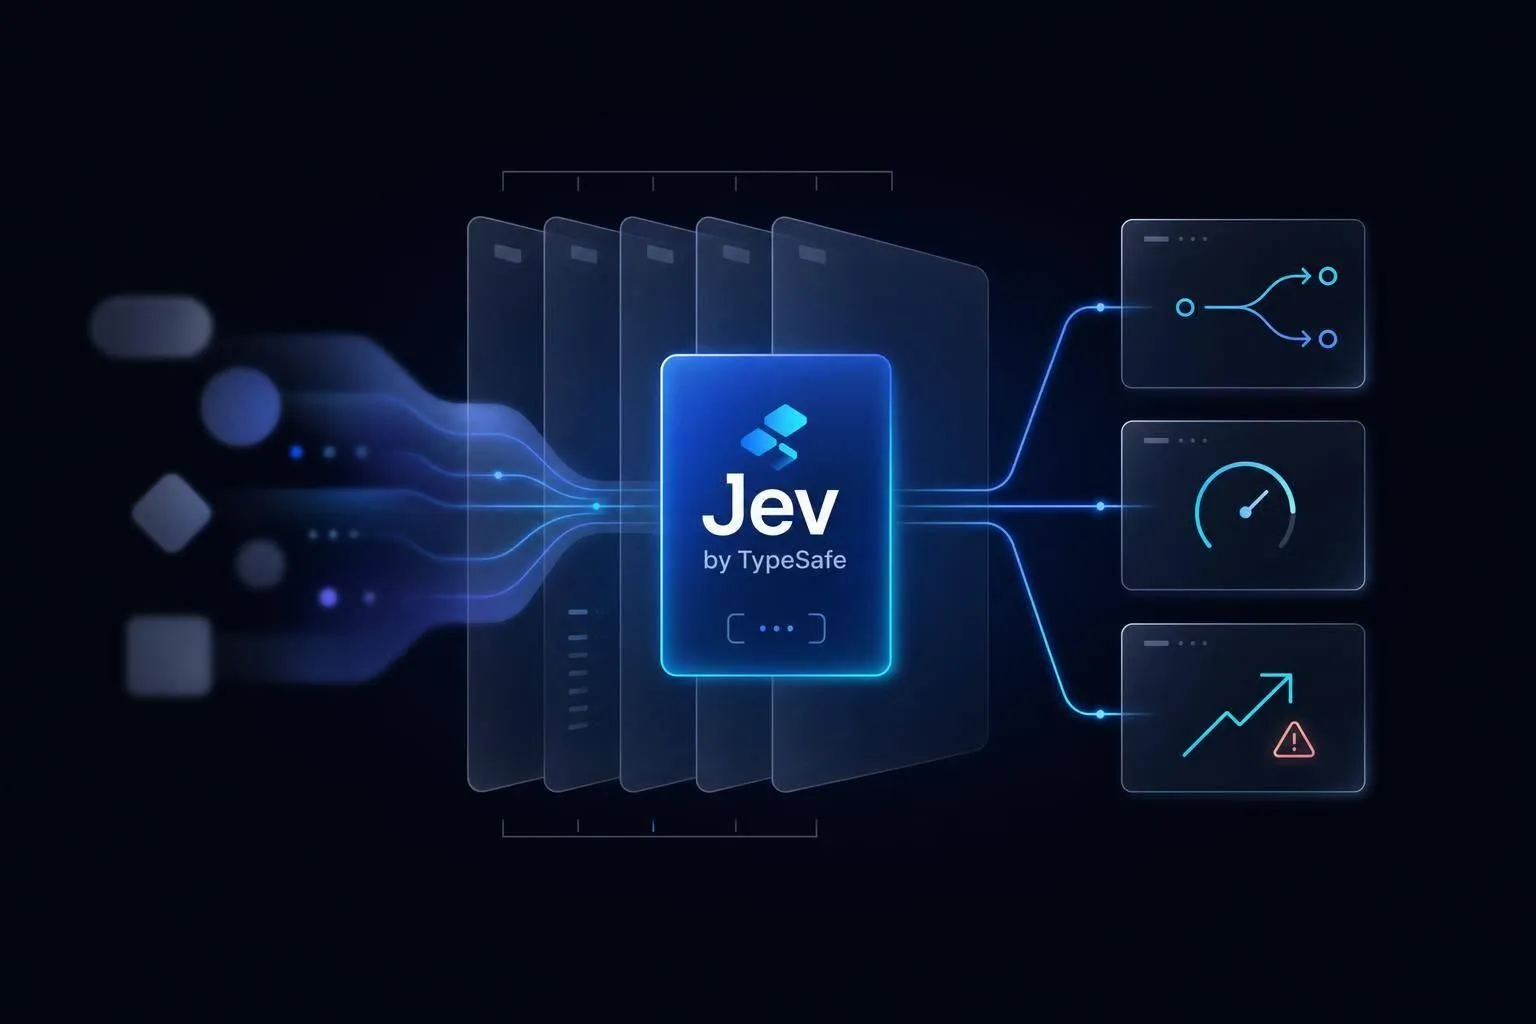
Bài đăng ra mắt của TypeSafe AI cho Jev đưa ra một tuyên bố cụ thể, có thể kiểm chứng: mô hình chạy nhanh hơn tới 193,6 lần và rẻ hơn tới 444,6 lần so với các mô hình ngôn ngữ frontier. Con số đó đã được lặp lại trong hàng chục bài viết suốt hai tuần kể từ khi ra mắt, gần như không ai kiểm tra lại nó với bất cứ thứ gì.
Một số ít người đã kiểm tra. Các bài test độc lập được công bố kể từ khi Jev ra mắt ngày 15 tháng 9 năm 2026 cho thấy lợi thế tốc độ thực tế của nó gần hơn với 5 đến 25 lần, không phải 193,6 lần, và không bài test nào tìm thấy Jev chính xác hơn các mô hình frontier mà nó được so sánh cùng. Khoảng cách giữa tiêu đề và thực tế được đo lường đó mới là câu chuyện thật sự.
Bài viết này trình bày chính xác những gì TypeSafe tuyên bố, cách công ty đưa ra những con số đó, những gì người kiểm thử độc lập tìm thấy khi tự chạy so sánh riêng, giới developer trên Hacker News phản ứng ra sao, và một cách thực tế để đánh giá xem Jev có đáng tin cho việc bạn thực sự định dùng nó hay không.
TypeSafe thực sự tuyên bố điều gì?
Khi ra mắt, TypeSafe báo cáo thời gian phản hồi từ 70 đến 500 mili giây và nói Jev chạy nhanh hơn 40 đến 200 lần so với LLM frontier trên các tác vụ tương đương, với tuyên bố đỉnh điểm 193,6 lần trên các workflow nội bộ. Về chi phí, token đầu vào có giá 0,042 đô la trên một triệu, đầu ra miễn phí, điều công ty đóng khung là rẻ hơn 40 đến 400 lần, đỉnh điểm là tuyên bố 444,6 lần. Chúng tôi đã trình bày Jev thực sự là gì và khác một mô hình như GPT-6 Astra hay Claude Fable 5.1 ra sao trong một bài trước; bài này nói về việc liệu các con số đó có đứng vững hay không.
TypeSafe đưa ra những con số này bằng cách nào?
Phương pháp luận quan trọng không kém kết quả. Thay vì công bố lên leaderboard công khai, TypeSafe chấm các bài đánh giá workflow của chính họ bằng cách so khớp với câu trả lời trung bình của GPT-6 Astra và Claude Fable 5.1, không phải với ground truth được kiểm chứng độc lập. Trên thực tế, điều đó nghĩa là câu trả lời tham chiếu cho một câu hỏi cho trước là bất cứ điều gì hai mô hình đó nói trung bình, nên bài test đo mức độ Jev đồng ý với hai hệ thống AI khác chứ không phải liệu bất kỳ mô hình nào trong số đó có thực sự đúng hay không. TypeSafe đã thừa nhận các con số nổi bật của họ là kết quả ở trường hợp tốt nhất chứ không phải hiệu suất điển hình trên mọi loại công việc.
Các bài test độc lập thực sự tìm thấy điều gì?
Khi các developer tự chạy so sánh riêng thay vì dùng của TypeSafe, các con số bội số giảm đáng kể. Một bản tổng hợp các bài test độc lập ban đầu cho thấy:
- Một tác vụ rà soát tài liệu trên 37 tài liệu và 777 đánh giá cho thấy Jev nhanh hơn khoảng 25 lần và rẻ hơn 580 lần so với Claude Fable 5.1, nhưng chỉ bắt được 6 trên 7 lỗi cài cắm, trong khi Fable 5.1 bắt được cả 7.
- Một đánh giá dựa trên rubric với 6.003 lượt kiểm tra cho thấy Jev chỉ rẻ hơn 1,6 lần so với DeepSeek V4.1 Flash, với tỷ lệ đồng ý 91,5% so với 93,5% của DeepSeek, và không kiểm tra tốc độ.
- Một đánh giá trên 50 tin đăng bất động sản thật cho thấy Jev nhanh hơn khoảng 5 lần và rẻ hơn 8,6 lần, với độ chính xác 96% so với 84% của Mistral Small 4 và 86% của Gemini 3.5 Flash-Lite, bài test duy nhất mà độ chính xác của Jev thực sự dẫn trước.
Mô hình nhất quán xuất hiện qua các bài test này: lợi thế tốc độ và chi phí thật sự tồn tại và đôi khi đáng kể, nhưng con số bội số phụ thuộc nhiều vào mô hình nào được dùng làm chuẩn so sánh. Một mô hình nặng hơn, chậm hơn làm điểm so sánh sẽ tạo ra một bội số lớn hơn, đó nhiều khả năng chính xác là cách con số 193,6 lần của TypeSafe được tạo ra. Không bài test độc lập nào tìm thấy Jev rõ ràng chính xác hơn các mô hình frontier mà nó được đo cùng, và trong hai trên ba bài test ở trên, nó kém chính xác hơn một chút.
Giới developer trên Hacker News phản ứng ra sao?
Thread Hacker News công bố Jev đạt 1.655 điểm và 456 bình luận chỉ trong một ngày, một phản ứng gây chú ý với một mô hình closed-source từ một startup vừa ra khỏi giai đoạn ẩn mình. Ban đầu nó có tiêu đề New frontier model 40 to 400x cheaper and 20 to 200x faster, và bị đổi tên trong vòng một giờ, một dấu hiệu nhỏ nhưng đáng chú ý về cách cách đóng khung đó được đón nhận khi người ta đọc qua tiêu đề.
Quan điểm chiếm ưu thế xuất hiện là Jev thực sự là một bộ phân loại và định tuyến zero-shot có năng lực, và việc gọi nó là frontier model thổi phồng những gì nó làm được. Một bình luận được trích dẫn nhiều nói thẳng vấn đề cốt lõi: Jev không thể phát ra một kiểu không hợp lệ, nhưng vẫn có thể phát ra một giá trị hợp lệ nhưng sai, một đảm bảo hẹp hơn nhiều so với những gì cụm từ không thể hallucinate gợi ý.
Demo chơi Doom, và vì sao nó kém ấn tượng hơn vẻ ngoài
TypeSafe minh họa Jev chơi Doom với khoảng 10 quyết định mỗi giây, tốn khoảng 7 đô la một giờ, tạo nên một hình ảnh ra mắt gây ấn tượng. Chi tiết bị bỏ sót là Jev đọc mô tả văn bản về trạng thái game thay vì nhìn pixel trên màn hình, và giới phê bình chỉ ra một bot dựa trên luật đơn giản đọc cùng mô tả trạng thái đó cũng có thể chơi tốt tương đương. Đây là một demo kỹ thuật thật, nhưng nó chứng minh khả năng ra quyết định nhanh trên đầu vào có cấu trúc, không phải điều gì gần với trí tuệ chơi game tổng quát.
Chính TypeSafe đã thừa nhận điều gì?
Công bằng mà nói, công ty không hề phớt lờ những chỉ trích. Nhà sáng lập Diogo Almeida đã phản hồi các câu hỏi về độ chính xác bằng cách nói rằng nút thắt cổ chai là dữ liệu huấn luyện cho việc hiệu chỉnh chứ không phải kiến trúc của mô hình, một mức độ tự phê bình khác thường để đưa ra ngay gần thời điểm ra mắt. Phản hồi đó đáng được ghi nhận đúng như nó là: nó cho thấy TypeSafe xem khoảng cách về độ chính xác là một vấn đề dữ liệu mà họ kỳ vọng sẽ thu hẹp theo thời gian, không phải một giới hạn nền tảng của cách tiếp cận này, dù đó là một tuyên bố về tương lai chứ không phải một sự thật về sản phẩm hôm nay.
Jev có thực sự nhanh hơn và rẻ hơn không? Một cách đọc công bằng
Có, thật sự, chỉ là không đạt mức chênh lệch như tiêu đề nêu. Mọi bài test độc lập đo tốc độ đều tìm thấy một lợi thế thật, dao động khoảng 5 đến 25 lần thay vì 193,6 lần, và lợi thế chi phí đôi khi rất lớn, lên tới 580 lần trong một bài test. Đó vẫn là một lợi thế có ý nghĩa cho các quyết định hẹp, khối lượng lớn nơi độ trễ và chi phí cộng dồn. Điều mà kiểm thử độc lập không ủng hộ là bất kỳ tuyên bố nào rằng Jev chính xác hơn các mô hình frontier mà nó được so sánh cùng. Về độ chính xác, cách đọc trung thực là Jev đánh đổi một phần độ đúng đắn để lấy một lượng lớn tốc độ và chi phí, một sự đánh đổi hợp lý cho nhiều use case và tệ cho những use case khác.
Cách đánh giá xem Jev có đáng tin cho use case của bạn
- Đừng tin bội số mà TypeSafe hay bất kỳ ai khác trích dẫn. Hãy test Jev với chính mô hình bạn sẽ dùng thay thế cho tác vụ cụ thể của mình, không phải bất kỳ mô hình nào tạo ra khoảng cách lớn nhất trong benchmark của người khác.
- Cân nhắc độ chính xác song song với tốc độ. Một mô hình trả lời tức thì nhưng sai nhiều trường hợp cụ thể của bạn hơn thì không thực sự rẻ hơn một khi bạn tính cả chi phí của những lỗi đó.
- Xem không thể hallucinate là một tuyên bố hẹp, không phải một đảm bảo an toàn. Jev không thể trả về câu trả lời ngoài schema, nhưng vẫn có thể tự tin trả về câu trả lời sai bên trong đó.
- Khớp công cụ với hình dạng tác vụ, dùng khung trong bài Jev so với ChatGPT và Claude của chúng tôi: các quyết định hẹp, khối lượng lớn, được định nghĩa rõ là nơi một mô hình như Jev có cơ hội thật sự chứng minh giá trị.
Kết lại
Jev là một tiến bộ kỹ thuật chính đáng với lợi thế tốc độ và chi phí thật, đo lường được so với LLM đa dụng trên các quyết định hẹp, có cấu trúc. Nó không phải là sản phẩm nhanh hơn 193,6 lần, rẻ hơn 444,6 lần như bài đăng ra mắt ngụ ý, và chưa bài test độc lập nào cho thấy nó vượt các mô hình frontier về độ chính xác. Cả hai điều đó có thể đúng cùng lúc, và không điều nào nên được nhận nguyên vẹn từ bài đăng ra mắt của một công ty, kể cả TypeSafe, hay từ chính bài viết này. Hãy tự test nó trên tác vụ của bạn trước khi để nó chạm vào bất cứ thứ gì trong production.
Nếu bạn muốn được hỗ trợ xây dựng một quy trình đánh giá tách bạch lợi ích thật khỏi marketing ngày ra mắt trước khi áp dụng một công cụ AI mới, dịch vụ đào tạo AI của chúng tôi có thể giúp đội của bạn thiết lập đúng cách. Liên hệ với chúng tôi và chúng tôi sẽ xem xét điều bạn đang cố quyết định.
Câu hỏi thường gặp
Jev AI có đáng tin không?
Có, theo nghĩa nó là một mô hình thật, hoạt động thật, với lợi thế tốc độ và chi phí thật so với LLM đa dụng cho các quyết định hẹp, có cấu trúc. Nó không đáng tin theo nghĩa mà marketing ra mắt ngụ ý: các bài test độc lập tìm thấy mức tăng thực tế gần 5 đến 25 lần, không phải 193,6 lần như tuyên bố, và chưa bài test độc lập nào tìm thấy nó chính xác hơn các mô hình frontier mà nó được so sánh cùng.
Jev có thực sự nhanh hơn ChatGPT 200 lần không?
Đó là tuyên bố nổi bật của chính TypeSafe, đến từ benchmark nội bộ của công ty chứ không phải kiểm thử độc lập. Các bài test độc lập công bố sau khi ra mắt tìm thấy lợi thế tốc độ thật, nhưng thường trong khoảng 5 đến 25 lần thay vì 193,6 đến 200 lần, với bội số chính xác phụ thuộc nhiều vào mô hình nào được dùng làm chuẩn so sánh.
Benchmark của Jev do TypeSafe công bố có đáng tin không?
Nên đọc với sự thận trọng. TypeSafe chấm các bài đánh giá workflow của chính họ bằng cách so khớp với câu trả lời trung bình của GPT-6 Astra và Claude Fable 5.1 thay vì ground truth được kiểm chứng độc lập, và chưa công bố kết quả lên leaderboard công khai. Công ty đã thừa nhận các con số nổi bật của họ đại diện cho kết quả ở trường hợp tốt nhất chứ không phải hiệu suất điển hình.
Jev có chính xác hơn các mô hình frontier như GPT-6 Astra hay Claude Fable 5.1 không?
Chưa bài test độc lập nào cho thấy điều đó. Qua các đánh giá độc lập được công bố kể từ khi ra mắt, độ chính xác của Jev nhìn chung tương đương hoặc kém hơn một chút so với các mô hình frontier mà nó được đo cùng trong phần lớn trường hợp, đánh đổi một phần độ đúng đắn để lấy lợi thế thật về tốc độ và chi phí.
Jev đã được kiểm chứng độc lập chưa?
Một phần. Một số ít developer độc lập đã tự chạy so sánh riêng với phương pháp luận và code được công bố kể từ khi ra mắt, và kết quả của họ nhất quán cho thấy lợi thế tốc độ và chi phí nhỏ hơn con số nổi bật của TypeSafe. Chưa có một benchmark độc lập, tiêu chuẩn hóa, quy mô lớn tương đương các leaderboard LLM công khai nào tồn tại cho Jev tính tới cuối tháng 9 năm 2026.
Cần hỗ trợ triển khai?
Growthtrait có thể giúp bạn áp dụng điều này vào thực tế. Cùng trao đổi về mục tiêu của bạn.
Liên hệ ngay