Hỏi xem Jev có thắng ChatGPT hay Claude không là đang hỏi sai câu hỏi. Jev, GPT-6 Astra và Claude Fable 5.1 đều ra mắt trong cùng ba tuần của tháng 9 năm 2026, và rất dễ bị cám dỗ đặt cả ba lên cùng một biểu đồ. Nhưng Jev chưa bao giờ được xây để cạnh tranh với một chat model. Nó được xây để xử lý phần việc mà một chat model là quá thừa thãi.
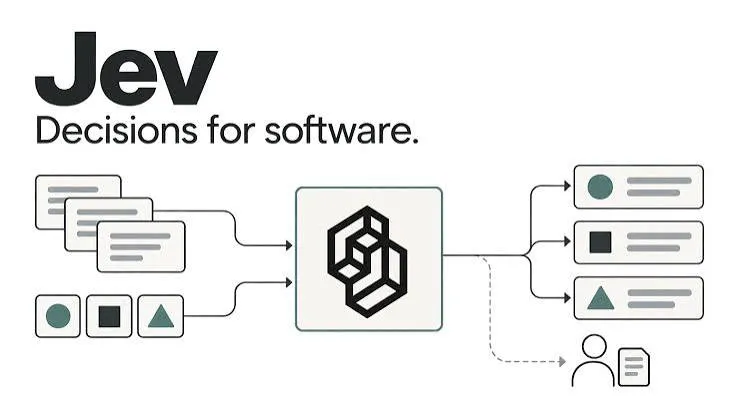
Sự khác biệt đó quan trọng hơn bất kỳ benchmark nào. GPT-6 Astra và Claude Fable 5.1 là các mô hình ngôn ngữ lớn: chúng đọc và viết văn bản mở, trò chuyện, và suy luận qua một vấn đề qua nhiều bước. Jev là thứ TypeSafe AI gọi là System One model, hay thứ ngành công nghiệp bắt đầu gọi là decision model: nó nhận một câu hỏi đã gõ kiểu và trả về một câu trả lời đã gõ kiểu kèm xác suất, và hoàn toàn không thể tạo ra văn bản tự do.
Bài viết này không nói về việc ai thắng. Nó trình bày điều thực sự phân biệt một decision model như Jev với một LLM đầy đủ như GPT-6 Astra hay Claude Fable 5.1, chỗ nào mỗi loại là công cụ tốt hơn, những đánh đổi thực sự về chi phí, độ trễ và độ chính xác, và một khung quyết định đơn giản để chọn loại nào thuộc về phần nào trong quy trình của bạn.
Chúng ta đang thực sự so sánh cái gì?
GPT-6 Astra và Claude Fable 5.1 là các language model autoregressive: chúng sinh phản hồi theo từng token, mỗi token được định hình bởi mọi thứ đã sinh ra trước đó, điều cho phép chúng viết một đoạn văn, trò chuyện, giải thích lý lẽ, hoặc điều hướng trình duyệt qua nhiều bước.
Jev hoạt động khác đi một cách có chủ đích. Nó là non-autoregressive, sinh ra đầu ra đã gõ kiểu trong một lượt song song duy nhất thay vì từng token, và câu trả lời của nó phải khớp với một schema đã định trước: một lựa chọn từ một tập cố định, một điểm số theo các mức có thứ tự, hoặc một đánh giá có hay không. Không có bài luận, không có giải thích, không có trò chuyện. Đó là toàn bộ sự so sánh trong một câu: một LLM viết, một decision model quyết định.
Mức độ phù hợp công việc: mỗi loại thực sự được xây cho việc gì
Đặt hai danh mục này cạnh các tác vụ thực tế thì sự phân chia trở nên rõ ràng.
- Viết mở, giải thích, hoặc một cuộc trò chuyện nhiều lượt: một LLM đầy đủ như GPT-6 Astra hay Claude Fable 5.1, vì đó là thứ mà sinh autoregressive được tạo ra để làm.
- Phân loại, định tuyến, chấm điểm, hoặc kiểm định đầu ra của một hệ thống khác: một decision model như Jev, vì câu trả lời đã khớp với một tập lựa chọn cố định và tốc độ quan trọng hơn văn xuôi.
- Suy luận nhiều bước qua một bài toán mơ hồ: một LLM đầy đủ, vì một decision model không thể giữ một chuỗi suy luận mở theo cách một chat model làm được.
- Điều hướng một giao diện thực qua nhiều bước, công việc computer use và browser use được trình bày trong bài viết về ChatGPT Atlas của chúng tôi: một LLM đầy đủ được xây cho việc đó, như GPT-6 Astra.
- Một quyết định nhanh đơn lẻ bên trong chính workflow duyệt web đó, như đánh giá xem một trang đang hiển thị nút thêm vào giỏ hàng hay thông báo hết hàng: một decision model, vì một chat model đầy đủ là thừa cho một lệnh gọi đó.
Chi phí và độ trễ: nơi khoảng cách là thật
Đây là chỗ khác biệt không còn là lý thuyết. TypeSafe định giá Jev ở 0,042 đô la trên một triệu token đầu vào với đầu ra miễn phí, và báo cáo thời gian phản hồi từ 70 đến 500 mili giây. Giá API tiêu chuẩn cho GPT-6 Astra và Claude Fable 5.1 vào khoảng 10 đô la trên một triệu token đầu vào và 50 đô la trên một triệu token đầu ra, với chi phí thực tế pha trộn gần 7 đến 8 đô la trên một triệu token khi tính cả cache, như chúng tôi đã trình bày trong bài so sánh GPT-6 Astra và Claude Fable 5.1.
Đó là một khoảng cách thật sự cho các quyết định hẹp, khối lượng lớn, và đó là toàn bộ lý do một decision model tồn tại. Nhưng đây cũng không phải một so sánh hoàn toàn công bằng. Một language model sinh ra tên kiểu, schema và văn xuôi giải thích đang làm nhiều việc hơn trên mỗi lệnh gọi so với một mô hình chỉ phát ra một quyết định bị giới hạn, nên một con số thô như tuyên bố nhanh hơn 40 đến 200 lần của Jev nên được đọc như trường hợp tốt nhất chứ không phải quy tắc cho mọi tác vụ.
Độ chính xác và sự đúng đắn: các kiểu sai khác nhau
Hai danh mục này không chỉ hoạt động khác nhau, chúng còn sai theo những cách khác nhau. Kiểu sai kinh điển của một language model là hallucination: bịa ra một sự thật, trôi khỏi chủ đề, hoặc tạo ra một câu trả lời nghe tự tin nhưng không có căn cứ thật. Giới hạn không gian câu trả lời chính xác là thứ Jev được xây để ngăn chặn, đó là cơ sở cho tuyên bố của TypeSafe rằng nó không thể hallucinate.
Tuyên bố đó hẹp hơn vẻ ngoài của nó. Jev không thể trả về câu trả lời ngoài schema đã cho, nhưng vẫn có thể tự tin trả về câu trả lời sai bên trong schema đó, một điểm khác biệt mà giới developer nêu ra nhanh chóng sau khi ra mắt. Cũng đáng nhớ: các benchmark do chính TypeSafe công bố chấm các bài đánh giá workflow của Jev bằng cách so khớp với câu trả lời trung bình của GPT-6 Astra và Claude Fable 5.1, không phải với ground truth được kiểm chứng độc lập, nên bài kiểm tra độ chính xác công bằng nhất cho cả hai danh mục vẫn là bài kiểm tra bạn tự chạy trên tác vụ của mình.
Decision model so với browser use: không phải cùng một câu hỏi
Rất dễ nhầm lẫn so sánh này với một so sánh khác: decision model so với browser use agent. Đây không phải cùng một trục. Khả năng computer use của GPT-6 Astra và công việc duyệt web mà ChatGPT Atlas tiên phong đều xoay quanh việc điều hướng một giao diện thực qua nhiều bước, nhấn chuột, điền form, quyết định bước tiếp theo. Jev hoàn toàn không được xây để tự lái trình duyệt. Nó được xây cho quyết định đơn lẻ bên trong một trong những bước đó. Một pipeline agentic thực tế nhiều khả năng sẽ dùng cả hai cùng lúc hơn là chọn một trong hai: một language model lên kế hoạch và hành động qua một phiên duyệt web, và một decision model xử lý các lệnh gọi phân loại nhanh dọc đường.
Một khung đơn giản: khi nào dùng cái nào
Thay vì chọn ra một người thắng, hãy dùng hình dạng của tác vụ để quyết định.
- Dùng một LLM đầy đủ như GPT-6 Astra hay Claude Fable 5.1 khi tác vụ cần viết mở, giải thích, một cuộc trò chuyện thật, phán đoán tinh tế không có tập câu trả lời cố định, hoặc tự lái một phiên duyệt web từ đầu đến cuối.
- Dùng một decision model như Jev khi bạn đang đưa ra cùng một quyết định hẹp ở khối lượng lớn, câu trả lời thực sự khớp với một tập lựa chọn đã gõ kiểu cố định, độ trễ hoặc chi phí ở quy mô lớn thực sự quan trọng, và bạn có thể kiểm chứng độ chính xác dựa trên ground truth của chính mình trước khi tin dùng nó trong production.
- Hãy kỳ vọng dùng cả hai trong cùng một pipeline thay vì chọn một. Một language model xử lý việc sinh nội dung, lên kế hoạch và trò chuyện. Một decision model xử lý các lệnh gọi phân loại, định tuyến và kiểm định rải rác xuyên suốt.
Kết lại
Jev không cố thay thế ChatGPT hay Claude, và cả GPT-6 Astra lẫn Claude Fable 5.1 đều không được xây để làm điều Jev làm. Câu hỏi hữu ích hơn chưa bao giờ là ai thắng. Mà là bạn thực sự đang có hình dạng bài toán nào, và khớp mô hình với hình dạng đó thay vì với bất cứ mô hình nào đang ồn ào nhất trong bài đăng ra mắt tháng này.
Nếu bạn đang xây dựng một pipeline AI và cố xác định mô hình nào thuộc về đâu, dịch vụ đào tạo AI của chúng tôi được xây để giúp đội của bạn đưa ra quyết định đó dựa trên dữ liệu của chính mình, không phải benchmark của nhà cung cấp. Liên hệ với chúng tôi và chúng tôi sẽ xem xét quy trình của bạn.
Câu hỏi thường gặp
Jev có tốt hơn ChatGPT không?
Jev và ChatGPT không được xây cho cùng một công việc, nên tốt hơn tùy vào tác vụ. Với viết mở, trò chuyện, hoặc duyệt web, GPT-6 Astra, mô hình hiện đang vận hành ChatGPT, là công cụ đúng. Với các quyết định phân loại, định tuyến hoặc chấm điểm nhanh, khối lượng lớn, Jev thường nhanh hơn và rẻ hơn, dù các benchmark công bố của nó là tự báo cáo.
Jev có tốt hơn Claude không?
Sự phân biệt tương tự áp dụng. Claude Fable 5.1 là một language model đầy đủ được xây cho suy luận, lập trình và các tác vụ mở, trong khi Jev là một decision model được xây cho các quyết định có cấu trúc, đã gõ kiểu ở khối lượng lớn. Chúng là công cụ bổ trợ cho nhau chứ không phải thay thế trực tiếp lẫn nhau.
Khác biệt giữa decision model và LLM là gì?
Một LLM như GPT-6 Astra hay Claude Fable 5.1 sinh văn bản mở theo từng token và có thể trò chuyện hoặc giải thích lý lẽ của nó. Một decision model như Jev trả về một giá trị đã gõ kiểu từ một tập lựa chọn định trước, chẳng hạn một lựa chọn, một điểm số, hoặc một câu trả lời có hay không, và hoàn toàn không thể tạo ra văn bản tự do.
Jev có thể thay thế hoàn toàn ChatGPT hoặc Claude không?
Không. Jev không thể viết văn bản mở, trò chuyện, hoặc giải thích lý lẽ của nó, nên nó không thể thay thế một chat model đa dụng. Nó được xây để xử lý một danh mục tác vụ hẹp hơn, chẳng hạn phân loại hoặc định tuyến, thường đi cùng một LLM đầy đủ thay vì thay thế nó.
Tôi có nên dùng Jev cho các tác vụ browser use không?
Không phải để tự lái trình duyệt. Công việc browser use và computer use, như điều hướng một trang qua nhiều bước, được tích hợp vào các mô hình như GPT-6 Astra. Jev phù hợp bên trong loại workflow đó cho một quyết định nhanh đơn lẻ, như đánh giá một trang đang hiển thị gì, chứ không phải để điều khiển toàn bộ phiên làm việc từ đầu đến cuối.
Cần hỗ trợ triển khai?
Growthtrait có thể giúp bạn áp dụng điều này vào thực tế. Cùng trao đổi về mục tiêu của bạn.
Liên hệ ngay