Hỏi một chatbot AI thông thường về chính sách đổi trả hay kết quả chiến dịch quý trước của bạn, nó sẽ đoán hoặc nói không biết. Mô hình được huấn luyện trên dữ liệu công khai tới một thời điểm và chưa từng thấy tài liệu của bạn.
Retrieval-augmented generation, hay RAG, giải quyết điều đó bằng cách tìm những đoạn liên quan nhất trong nội dung của bạn và đưa cho mô hình trước khi nó trả lời. Ý tưởng thì đơn giản. Xây một hệ thống RAG trả lời đáng tin thì không, và khác biệt nằm ở một vài quyết định thiết kế.
Hướng dẫn này giải thích RAG hoạt động thế nào, rồi đi qua các quyết định quyết định chất lượng: chia đoạn tài liệu ra sao, tìm kiếm ra sao, rerank ra sao, đánh giá ra sao, chi phí bao nhiêu, một ví dụ cụ thể và các kiểu lỗi cần lường trước.
RAG là gì?
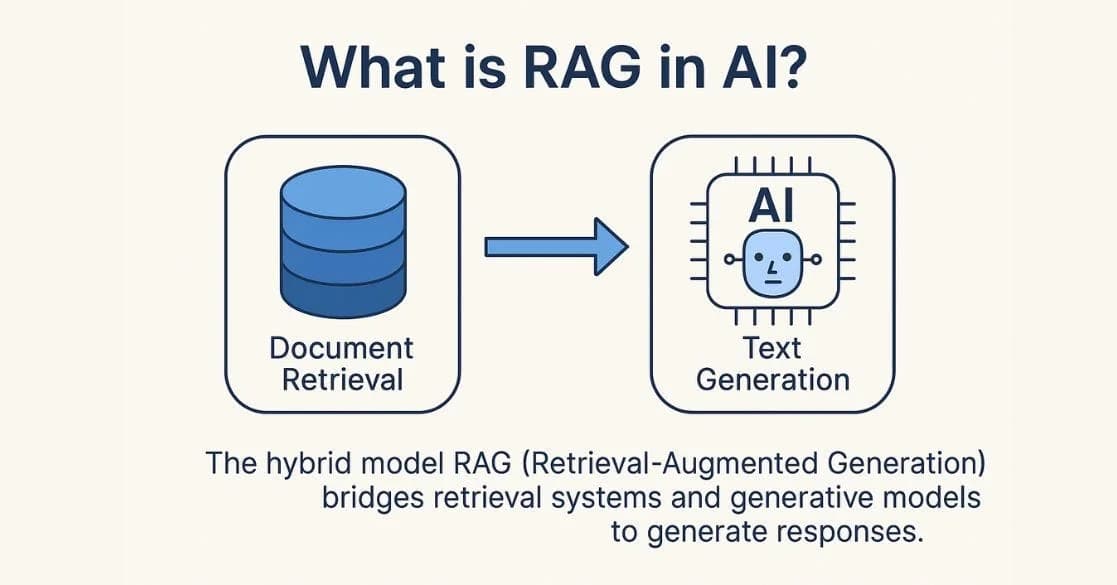
RAG kết hợp truy xuất, tức tìm thông tin liên quan trong một bộ tài liệu được chọn, với tạo sinh, tức một mô hình ngôn ngữ lớn viết câu trả lời từ thông tin đó. Cách tiếp cận này được giới thiệu trong bài nghiên cứu năm 2020 của Patrick Lewis và cộng sự tại Facebook AI Research, và đã trở thành cách tiêu chuẩn để kết nối AI với tri thức doanh nghiệp.
RAG hoạt động như thế nào?
Một hệ thống RAG có hai luồng. Luồng lập chỉ mục chạy trước; luồng truy vấn chạy mỗi khi có câu hỏi.
Luồng lập chỉ mục
- Thu thập và làm sạch tài liệu: bỏ phần điều hướng, bản trùng và phiên bản cũ.
- Chia thành các đoạn nhỏ, mỗi đoạn trả lời được một phần câu hỏi.
- Chuyển mỗi đoạn thành embedding, một vector thể hiện ý nghĩa.
- Lưu embedding, nội dung đoạn và metadata như nguồn, ngày cập nhật, quyền truy cập vào vector database.
Luồng truy vấn
- Chuyển câu hỏi thành embedding.
- Truy xuất các đoạn giống nhất, lọc theo metadata như quyền của người dùng.
- Rerank kết quả nếu cần.
- Dựng prompt gồm câu hỏi, các đoạn tốt nhất và chỉ dẫn chỉ trả lời từ chúng, kèm trích dẫn nguồn.
- Tạo câu trả lời và hiển thị nguồn.
Quyết định 1: Chia đoạn tài liệu thế nào?
Cách chia đoạn ảnh hưởng tới chất lượng câu trả lời nhiều hơn phần lớn người nghĩ. Đoạn quá lớn chôn câu liên quan trong nhiễu; đoạn quá nhỏ mất ngữ cảnh cần để trả lời.
- Chia theo cấu trúc trước: heading, mục và danh sách, thay vì số ký tự cố định.
- Điểm xuất phát phổ biến là vài trăm token mỗi đoạn, có phần chồng lấn nhỏ giữa các đoạn liền kề, rồi điều chỉnh theo kết quả đánh giá.
- Giữ mỗi đoạn tự đứng được: kèm heading hoặc tiêu đề tài liệu để đoạn có nghĩa khi đọc riêng.
- Lưu metadata hữu ích cho mỗi đoạn: URL nguồn, ngày cập nhật, sản phẩm, khu vực và đối tượng.
- Xử lý riêng bảng và FAQ: mỗi cặp hỏi đáp một đoạn thường tốt hơn cắt ngang bảng.
Quyết định 2: Tìm kiếm thế nào?
- Tìm kiếm vector tìm đoạn có ý nghĩa giống, kể cả khi dùng từ khác.
- Tìm kiếm từ khóa, như BM25, tìm đúng thuật ngữ: mã sản phẩm, tên riêng, thông báo lỗi.
- Hybrid search kết hợp cả hai và thường đáng tin hơn từng cách riêng, nhất là với nội dung doanh nghiệp đầy tên riêng và mã số.
- Bộ lọc metadata thu hẹp phạm vi trước khi xếp hạng, ví dụ đúng sản phẩm, ngôn ngữ hay cấp quyền.
Quyết định 3: Rerank và gửi bao nhiêu ngữ cảnh
Bước tìm kiếm nhanh lấy về một tập ứng viên rộng, rồi mô hình rerank chấm kỹ từng ứng viên so với câu hỏi và giữ lại vài đoạn tốt nhất. Gửi ít đoạn nhưng tốt thường thắng gửi nhiều: rẻ hơn, giảm khả năng mô hình bị phân tâm bởi đoạn ít liên quan, và luôn nằm gọn trong cửa sổ ngữ cảnh của mô hình.
Quyết định 4: Viết prompt tạo câu trả lời
- Yêu cầu mô hình chỉ trả lời từ các đoạn được cung cấp.
- Nói rõ phải làm gì khi các đoạn không chứa câu trả lời: nói thẳng và gợi ý bước tiếp theo, thay vì đoán.
- Yêu cầu trích dẫn đoạn hoặc nguồn cho mọi khẳng định dữ kiện.
- Đặt giọng văn, độ dài và định dạng người dùng mong đợi.
Cách đánh giá một hệ thống RAG
Đánh giá riêng phần truy xuất và phần tạo câu trả lời để biết sửa chỗ nào:
- Xây bộ thử nghiệm 50 đến 100 câu hỏi thật, mỗi câu kèm tài liệu chứa câu trả lời.
- Tỷ lệ truy xuất trúng: phần trăm câu hỏi mà tài liệu đúng nằm trong top k kết quả. Nếu thấp, sửa cách chia đoạn, tìm kiếm hoặc metadata trước khi động tới prompt.
- Độ trung thực: phần trăm câu trả lời mà mọi khẳng định đều có căn cứ trong các đoạn được truy xuất.
- Độ liên quan: câu trả lời có thực sự trả lời câu hỏi không.
- Từ chối đúng: hệ thống có nói “không biết” khi tài liệu không có câu trả lời không.
Chạy lại bộ thử nghiệm sau mỗi thay đổi về cách chia đoạn, mô hình embedding, thiết lập tìm kiếm hay prompt.
Ví dụ: trợ lý chăm sóc khách hàng
Giả sử một cửa hàng có 300 bài trong trung tâm trợ giúp, trung bình 800 từ mỗi bài. Các con số dưới đây là minh họa:
- Chia theo mục, các bài tạo ra khoảng 1.500 đoạn, mỗi đoạn gắn tiêu đề bài, URL và danh mục sản phẩm.
- Tìm kiếm dạng hybrid, lọc theo danh mục sản phẩm khách đang hỏi.
- 20 ứng viên đầu được rerank và 4 đoạn tốt nhất được gửi cho mô hình, khoảng 1.000 token ngữ cảnh mỗi câu hỏi.
- Prompt yêu cầu chỉ trả lời từ các đoạn đó, kèm link bài nguồn, và chuyển sang nhân viên khi không đoạn nào trả lời được.
- Trước khi ra mắt, 80 ticket thật trong quá khứ được dùng làm bộ thử nghiệm. Tỷ lệ truy xuất trúng trong top 4 cho biết bản thân trung tâm trợ giúp có đang thiếu nội dung không.
Trong những dự án như thế này, lần đánh giá đầu tiên thường lộ ra vấn đề nội dung nhiều không kém vấn đề kỹ thuật: thiếu bài, chính sách cũ, hai trang mâu thuẫn nhau. Sửa nội dung thường cải thiện câu trả lời nhiều hơn tinh chỉnh hệ thống.
RAG tốn bao nhiêu chi phí?
- Lập chỉ mục: tạo embedding cho mọi đoạn một lần, rồi chỉ làm lại khi tài liệu thay đổi.
- Lưu trữ: vector database hoặc dịch vụ tìm kiếm được quản lý.
- Mỗi câu hỏi: một lần tạo embedding, lượt tìm kiếm, một lần rerank nếu có và một lần gọi mô hình tạo câu trả lời. Token đầu vào tăng theo số đoạn gửi đi, nên truy xuất ít đoạn mà tốt là đòn bẩy chi phí chính.
RAG khác fine-tuning như thế nào?
Fine-tuning thay đổi hành vi mô hình bằng cách huấn luyện thêm trên ví dụ. RAG thay đổi thông tin mô hình nhìn thấy lúc trả lời. Dùng RAG cho dữ kiện hay thay đổi hoặc cần trích dẫn; dùng fine-tuning cho văn phong, định dạng hay hành vi chuyên biệt nhất quán. Nhiều hệ thống thực tế dùng cả hai.
Các kiểu lỗi cần lường trước
- Nội dung cũ: câu trả lời lặp lại chính sách cũ vì tài liệu cũ vẫn còn trong chỉ mục.
- Truy xuất trượt: đoạn đúng có tồn tại nhưng không được tìm thấy, thường do chia đoạn kém hoặc thiếu tìm kiếm từ khóa.
- Nguồn mâu thuẫn: hai tài liệu nói khác nhau và mô hình chọn đại một bên.
- Lộ quyền truy cập: hệ thống truy xuất tài liệu người dùng không được xem. Áp bộ lọc quyền ngay lúc truy xuất, không phải sau đó.
- Đoán một cách tự tin: mô hình vẫn trả lời khi không truy xuất được gì liên quan. Cần chỉ dẫn và kiểm tra khả năng từ chối.
Nếu không kiểm soát những lỗi này, RAG giảm AI hallucination ít hơn nhiều so với kỳ vọng, vì vậy đánh giá quan trọng hơn bất kỳ lựa chọn công cụ nào.
RAG và tìm kiếm AI
Các công cụ tìm kiếm AI hoạt động theo cùng nguyên lý: truy xuất trang web rồi tạo câu trả lời từ đó. Nội dung viết thành những đoạn rõ ràng, tự đứng được và trả lời câu hỏi cụ thể sẽ dễ được truy xuất và trích dẫn hơn, cho cả hệ thống RAG của bạn lẫn tìm kiếm AI. Bài SEO, AEO và GEO hướng dẫn cách cấu trúc nội dung như vậy.
Bắt đầu từ đâu?
Chọn một bộ tài liệu rõ ràng và một nhóm người dùng. Nhiều nền tảng AI đã có sẵn tìm kiếm file, nên bạn có thể thử xem RAG có trả lời được câu hỏi thật không trước khi xây gì riêng. Viết bộ thử nghiệm trước, đo tỷ lệ truy xuất trúng và độ trung thực, sửa những chỗ nội dung còn thiếu, rồi mới quyết định có cần hệ thống tùy chỉnh không.
Nếu bạn muốn đội ngũ hiểu và dùng tự tin các công cụ như RAG, chương trình đào tạo AI của Growthtrait có thể giúp. Liên hệ với chúng tôi để lên kế hoạch buổi đào tạo.
Câu hỏi thường gặp
RAG là gì trong AI?
RAG (retrieval-augmented generation) là kỹ thuật trong đó hệ thống AI truy xuất các đoạn liên quan từ một bộ tài liệu trước, rồi dùng mô hình ngôn ngữ viết câu trả lời chỉ dựa trên các đoạn đó, thường kèm trích dẫn.
Nên chia đoạn tài liệu cho RAG thế nào?
Chia theo cấu trúc tài liệu như heading và mục, giữ mỗi đoạn tự đứng được kèm tiêu đề, lưu metadata như nguồn và ngày, bắt đầu với đoạn vài trăm token có chồng lấn nhỏ, rồi điều chỉnh theo kết quả đánh giá.
Hybrid search trong RAG là gì?
Hybrid search kết hợp tìm kiếm vector, khớp theo ý nghĩa, với tìm kiếm từ khóa như BM25, khớp đúng thuật ngữ như mã sản phẩm và tên riêng. Cách này thường đáng tin hơn từng phương pháp riêng với nội dung doanh nghiệp.
Đánh giá hệ thống RAG thế nào?
Dùng bộ câu hỏi thật kèm tài liệu nguồn đã biết. Đo tỷ lệ truy xuất trúng, độ trung thực của câu trả lời so với các đoạn được truy xuất, độ liên quan, và khả năng nói không biết khi tài liệu không có câu trả lời.
RAG khác fine-tuning thế nào?
RAG cung cấp thông tin liên quan lúc trả lời mà không thay đổi mô hình, phù hợp với dữ kiện hay thay đổi và cần trích dẫn. Fine-tuning huấn luyện thêm mô hình để thay đổi văn phong hoặc hành vi.
Cần hỗ trợ triển khai?
Growthtrait có thể giúp bạn áp dụng điều này vào thực tế. Cùng trao đổi về mục tiêu của bạn.
Liên hệ ngay